Lrama の Ruby Parser を Ruby で組みたてたい v 0.0.0
皆さんごぞんじだと思いますが Lrama っていう Ruby 製の パーサージェネレーター があります。
パーサージェネレーター で有名なのは、Yacc(yet another compiler compiler) や Bison があります。 Lrama はこの Yacc/Bison 形式 で書かれたパーサー定義ファイルから Parser(構文解析) を作ります。
Lrama は Yacc/Bison形式 の構文定義ファイルから parser を生成できます。 ただし、標準の出力先は C言語 で、 Ruby に向けのバックエンドはありません。
ないならしょうがない
出力されていないならしょうがないつくるしかない。 のでつくりましょう。 とその前にどのような parser にしたいのかというものを書いていきましょう。
- Lrama で Ruby の文法定義ファイル(parse.y) を読み込む
- 読み込んだ定義から Ruby 向け Parser を作る
- Lexer(字句解析) と生成した Parser を組合せて Ruby を読み込む入口となる Ruby ファイル を作る
- 作成した入口のプログラムを Ruby から利用できるようにする
というのが簡単な流れです。
Design Workflow
ということでやることが決まったので詳細を考えていきましょう。
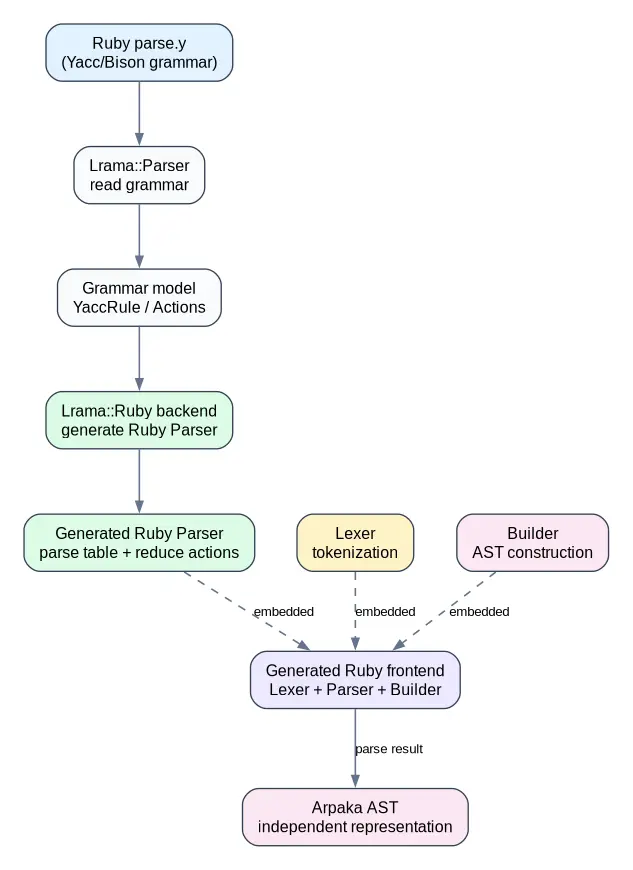
上の図が簡単な流れですね。
Lrama に Yacc/Bison 形式の定義ファイル を渡し、 文法(Grammar)と Action から Ruby Parser を生成します。 生成された Parser に Lexer と AST Builder を組み合わせ、 Ruby だけで動作する一つのフロントエンドファイルとして出力します。
ここで Action は、文法規則に対応して実行される意味処理です。 構文木のノードを組み立てる処理などを担当します。
Lexer は Ruby のソースを読み取り、 Parser が扱う token の列に変換します。 Parser はその token 列を文法定義に従って解析します。
Parser の処理の簡易的な流れは以下のようになります。
Ruby source -> Lexer -> token 列 -> Parser -> AST
生成されたファイルを Ruby の Parser として利用できるようにし、 Ruby から読み込んで Ruby プログラムを構文解析できるようにします。
おわり
設計が決まり実装していく手順が見えてきました。 次回は実際に実装していきましょう。